
Microsoft plant, ab 2027 mit dem Einsatz seines neuen KI-Systems Maia 300 im Multi-Gigawatt-Bereich zu beginnen und potenziell über eine Million der kundenspezifischen Beschleuniger zu installieren. Damit will das Unternehmen seine eigenen Chips zum primären Motor für KI-Inferenz in seinen Produkten und Diensten machen. Wie Reuters, würde diese Größenordnung einen bedeutenden Anteil der KI-Berechnungen von Microsoft von Allzweck-Grafikprozessoren hin zu Hardware verlagern, die speziell für die eigenen Workloads entwickelt wurde.
Das Unternehmen gab am Montag bekannt, dass ein Maia-300-Rack mit 96 Beschleunigern 40 % mehr Token pro Megawatt liefern soll als führende GPU-basierte Systeme und den bis zu siebenfachen Token-Durchsatz des Vorgängermodells Maia 200 erreichen soll. Es handelt sich dabei um Prognosen von Microsoft, nicht um unabhängig verifizierte Benchmarks: Das Unternehmen nannte das für den 40-%-Vergleich herangezogene Konkurrenzsystem nicht, und die Serienproduktion beginnt erst im nächsten Jahr.
Die Ankündigung ist von Bedeutung, da Inferenz – also das Ausführen eines trainierten Modells zur Beantwortung von Fragen, zum Generieren von Code oder zur Ausführung einer Aufgabenfolge – zunehmend zum wiederkehrenden Kostenfaktor kommerzieller KI wird. Indem Microsoft mehr Kontrolle über diese Hardware erlangt, versucht das Unternehmen, die Wirtschaftlichkeit des Betriebs von Copilot, GitHub, Foundry und seinen eigenen Modellen zu verbessern und gleichzeitig die Abhängigkeit von Beschleunigern von Nvidia und AMD zu verringern.
Ein auf Schlussfolgerungen basierendes System
Maia 300 ist nicht als direkter Ersatz für eine herkömmliche GPU konzipiert. Microsofts Produktbeschreibung beschreibt ein Design, das auf Inferenz basiert und für lange Kontexte, schnelle Dialogantworten und die kontinuierliche, mehrstufige Arbeit von Agenten ausgelegt ist. Acht Stacks aus HBM4-Speicher mit hoher Bandbreite bieten 288 Gigabyte Kapazität und eine Spitzenbandbreite von 18 Terabyte pro Sekunde für jeden Beschleuniger innerhalb eines thermischen Gehäuses von 950 Watt.
Das Design trennt Rechen-, Speichersteuerungs- und Ein-/Ausgabefunktionen in Chiplets. Die Rechenchips werden im N2P-Verfahren von Taiwan Semiconductor Manufacturing Co. gefertigt, während für andere Komponenten Fertigungsverfahren eingesetzt werden können, die auf Bandbreite, Konnektivität oder Kosten abgestimmt sind. Durch diese Aufteilung kann Microsoft seine fortschrittlichsten Siliziumchips für Aufgaben reservieren, bei denen das größte Effizienzpotenzial erwartet wird.
Die Datenübertragung steht im Mittelpunkt der Entwicklung. Laut Microsofts technischer Beschreibung nutzt der Chip softwaregesteuerten Datenfluss und ein nicht-uniformes Speicherlayout, um Informationen nahe an den Prozessoren zu halten, die sie benötigen. Formate mit geringerer Präzision reduzieren die Anzahl der übertragenen Bytes pro generiertem Token zusätzlich. Dieser Ansatz soll einen häufigen Engpass bei der Inferenz beheben: die schnelle Bereitstellung von Modellparametern und gespeichertem Kontext für die Recheneinheiten, um deren Auslastung zu gewährleisten.
Racks werden zur Wettbewerbseinheit
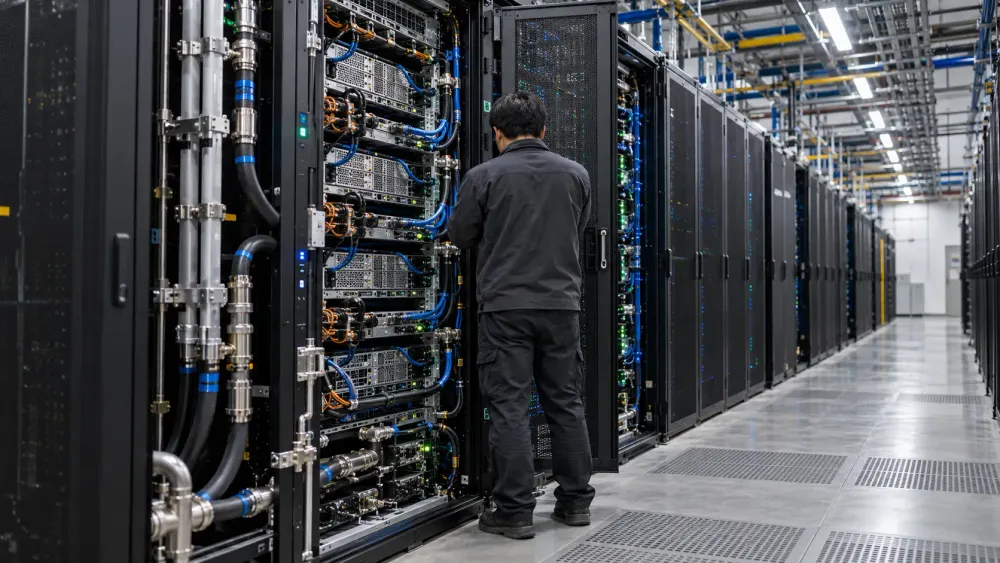
Jedes Maia-300-Rack vereint 96 Beschleuniger auf 24 flüssigkeitsgekühlten Einschüben und verbraucht bis zu 167 Kilowatt. Das komplette Rack verfügt über 27,6 Terabyte Arbeitsspeicher mit hoher Bandbreite und eine Gesamtspeicherbandbreite von 1,7 Petabyte pro Sekunde. Laut Microsoft reduziert die Flüssigkeitskühlung die Wärmelast des Racks um mehr als 80 %, während weniger anspruchsvolle Komponenten mit herkömmlicher Luftkühlung gekühlt werden.
Das Netzwerk ist ebenso wichtig. Ein Rack bildet einen Pod, und bis zu 128 Racks lassen sich zu einem „Superpod“ mit 12.288 Beschleunigern verbinden. Microsoft nutzt Ethernet-basierte Transportprotokolle und ein einheitliches Kommunikationsmodell für alle Racks. Dadurch können große Aufträge hardwareübergreifend ausgeführt werden, ohne dass jede Übertragung über ein separates Hostsystem geleitet werden muss. Das macht Maia 300 sowohl zu einer Rechenzentrumsarchitektur als auch zu einem Chip.
Die Angabe von 167 Kilowatt ist höher als die von Reuters genannten rund 142 Kilowatt für ein Nvidia GB300-Rack mit 72 GPUs. Microsofts Argumentation basiert auf der Leistung pro Energieeinheit, nicht auf dem geringeren Stromverbrauch des Racks. Diese Unterscheidung ist entscheidend, da Energieversorger und Rechenzentrumsbetreiber mit begrenzten Netzanschlüssen konfrontiert sind: Eine höhere Hardwaredichte schafft nur dann Mehrwert, wenn die zusätzliche Rechenleistung innerhalb einer festen Leistungszuweisung die höhere Last jedes Racks kompensiert.
Microsoft strebt Kontrolle über wiederkehrende KI-Kosten an
Microsoft setzt Maia 200 bereits produktiv für Copilot und die interne Modellentwicklung ein; GitHub Copilot und Microsoft Foundry werden voraussichtlich folgen. Laut The Verge soll Maia 300 zum primären Inferenzsystem für Microsofts Dienste werden – eine deutlich umfassendere Rolle als ein begrenztes internes Beschleunigungsprogramm.
Der Zeitpunkt spiegelt sowohl die Nachfrage als auch den Investitionsdruck wider. Im letzten Quartalsberichtgab Microsoft Investitionen in Höhe von 41 Milliarden US-Dollar bekannt, wovon rund zwei Drittel in kurzlebige Anlagen, vorwiegend CPUs und GPUs, flossen. Das Unternehmen rechnet nach einer buchhaltungsbedingten Umgliederung von Leasingverträgen mit Investitionen in Höhe von rund 175 Milliarden US-Dollar im Kalenderjahr 2026, während die Nachfrage nach Azure weiterhin die verfügbaren Kapazitäten übersteigt.
Kundenspezifische Chips eliminieren externe Zulieferer nicht. Microsoft bietet weiterhin eine heterogene Azure-Plattform an und kauft nach wie vor große Mengen an GPUs. Die Strategie besteht darin, gekaufte Hardware dort zu reservieren, wo Flexibilität oder Kompatibilität wichtig sind, während vorhersehbare, umfangreiche interne Inferenzprozesse auf Maia gelenkt werden. Bei hoher Auslastung können die Kontrolle über Software, Netzwerk und Chips die Kosten pro Token senken und die Abhängigkeit von einem einzelnen Beschleunigerhersteller reduzieren.
Die Behauptungen benötigen noch einen praktischen Beweis
Die wichtigsten Kennzahlen sind weiterhin zukunftsorientiert. Microsoft hat keine Ergebnisse für einzelne Workloads, Anschaffungskosten, Ausfallraten oder geprüfte Vergleiche mit namentlich genannten Konkurrenzsystemen veröffentlicht. Der siebenfache Durchsatz gegenüber Maia 200 resultiert aus mehreren Änderungen, darunter doppelt so viele Beschleuniger pro Rack, höhere Bandbreite, neue Präzisionsformate und ein höherer Stromverbrauch; es handelt sich nicht um eine einfache Leistungsmessung zwischen einzelnen Chips.
Die Implementierung im Millionen-Chip-Maßstab birgt auch Risiken in den Bereichen Fertigung, Speicherversorgung, Netzwerktechnik und Kühlung. TSMCs fortschrittliche Prozesskapazität und die Verfügbarkeit von HBM4-Chips beeinflussen, wie schnell Microsoft Systeme entwickeln kann, während die Softwareunterstützung darüber entscheidet, ob die Modelle auf der neuen Architektur effizient laufen. Selbst ein vielversprechendes Design kann durch geringe Auslastung, Planungsaufwand oder unausgereifte Tools an Leistung einbüßen.
Was der Rollout testen wird
Maia 300 markiert einen strategischen Schritt: vom Experimentieren mit kundenspezifischen Beschleunigern hin zu deren Integration in die Kerninfrastruktur. Die Einführung im Jahr 2027 wird zeigen, ob Microsoft die Kontrolle über die Architektur in messbare Kosten- und Energieeinsparungen pro sinnvoller KI-Antwort umsetzen kann, ohne die Modellauswahl oder die Zuverlässigkeit der Dienste einzuschränken.
Die aussagekräftigsten Ergebnisse werden nach Produktionsbeginn vorliegen: Auslastungsraten, Kundenverfügbarkeit, vergleichbare Leistungsdaten und der Anteil des auf Maia verlagerten Inferenzverkehrs von Microsoft. Die Ankündigung legt vorerst den geplanten Umfang und die technische Ausrichtung fest. Sie beweist jedoch noch nicht den Effizienzvorteil, den Microsoft als Rechtfertigung für diesen Umfang anführt.











