
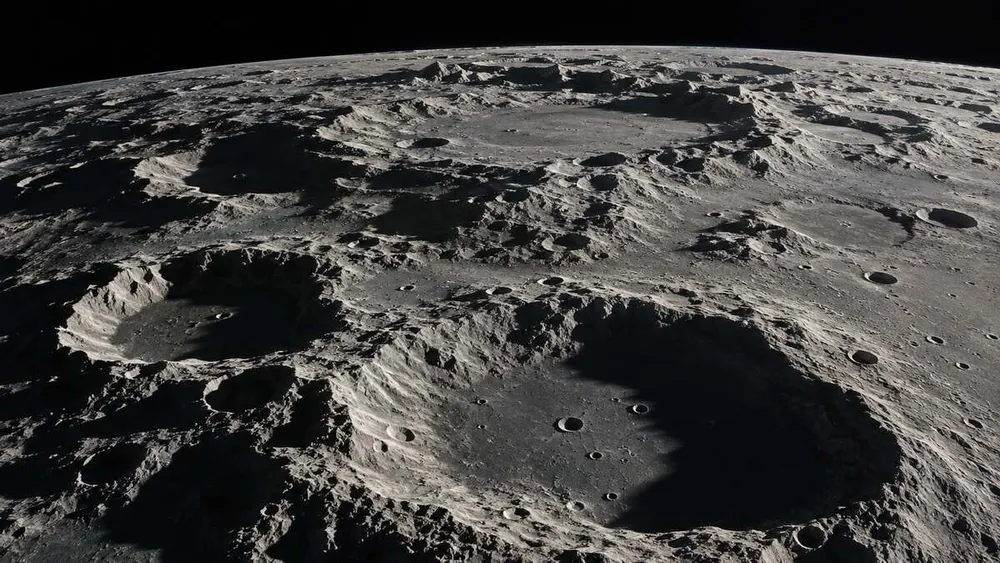
Ein neues Open-Source-KI-Modell, das mit rund zwei Millionen Mondbildkacheln trainiert wurde, kann Krater kartieren, ungewöhnliches Vulkangelände identifizieren und abschätzen, wo Eis in der Nähe der Mondpole stabil sein könnte. Dies gaben NASA und IBM am Donnerstag bekannt. Das NASA-IBM Lunar Foundation Model kombiniert über eine Million hochauflösende Kamerabilder mit fast 964.000 Multispektralbildern und bietet Forschern damit eine wiederverwendbare technische Grundlage für verschiedene Arten von Mondanalysen, anstatt für jede Aufgabe ein separates Modell zu benötigen.
Die NASA-Pressemitteilung beschreibt das System als eines der ersten Open-Source-Grundlagenmodelle, das speziell für die Mondforschung entwickelt wurde. Gewichtungen, nachgelagerte Modelle, Benchmark-Daten und Quellcode stehen für externe Tests zur Verfügung. Diese Offenheit ist wichtig, da der Wert des Modells nicht nur von den von den Entwicklern gemeldeten Benchmark-Ergebnissen abhängt, sondern auch davon, ob unabhängige Forscher die Ergebnisse reproduzieren und das System zuverlässig an verschiedene Instrumente, Lichtverhältnisse und wissenschaftliche Fragestellungen anpassen können.
In ersten Evaluierungen erreichte oder übertraf das Modell mehrere etablierte Vergleichsmodelle bei der Kraterkartierung und der Segmentierung unregelmäßiger Mare-Flächen und zeigte gleichzeitig deutliche Vorteile bei der Abschätzung der Stabilität des Polareises. Laut Reuters. Diese Ergebnisse sind vielversprechend, messen aber die Leistung bei definierten Forschungsaufgaben und nicht die endgültige Entscheidung über eine Landung oder den Nachweis von gewinnbarem Wasser.
Ein allgemeines Modell für Monddaten
Grundlagenmodelle werden anhand großer Datensätze trainiert, sodass ihre erlernten Repräsentationen mit relativ geringen Mengen an annotierten Daten an viele nachgelagerte Aufgaben angepasst werden können. In der Mondforschung kann dieser Ansatz den Bedarf an spezialisierten Modellen reduzieren, die Wissenschaftler jedes Mal von Grund auf neu entwickeln und trainieren müssen, wenn sie Krater zählen, geologische Formationen segmentieren oder Oberflächenveränderungen vergleichen möchten. Das neue Modell dient als gemeinsames visuelles Gerüst, das für ein spezifisches wissenschaftliches Problem feinabgestimmt werden kann.
Die Trainingsdaten stammen hauptsächlich vom Lunar Reconnaissance Orbiter (LRO) der NASA, der den Mond seit 2009 erforscht. Die Missionsdaten umfassen eine nahezu globale Oberflächenkartierung sowie Messungen von Temperatur, Zusammensetzung und Strahlung. Laut NASA übertrifft das Datenvolumen des LRO das aller anderen planetaren Missionen der NASA zusammen, was das Archiv zwar wertvoll, aber durch manuelle Auswertung schwer vollständig zu untersuchen macht.
Das Modell integriert außerdem Bild- und Geländedaten der NASA-Missionen Gravity Recovery and Interior Laboratory (GRIL) und Lunar Prospector (LP) sowie der japanischen Mission Selenological and Engineering Explorer (SEE). Die Kombination verschiedener Bilddatensätze ermöglicht es dem System, Zusammenhänge zu erkennen, die sich aus einem einzelnen Bildtyp nur schwer ableiten lassen. Hochauflösende Fotografien zeigen feine Oberflächenstrukturen, während multispektrale Beobachtungen und Geländedaten Informationen über Zusammensetzung, Höhe und Beleuchtung liefern.
Drei Tests mit praktischem Nutzen
Die Kratererkennung ist die intuitivste Anwendung. Wissenschaftler nutzen Anzahl, Größe und Verteilung von Einschlagkratern, um das relative Alter von Mondoberflächen abzuschätzen und Teile der Geschichte des Sonnensystems zu rekonstruieren. Die automatisierte Erkennung in riesigen Archiven kann diese Arbeit beschleunigen und den Vergleich von Regionen erleichtern. Dennoch bleibt die menschliche Überprüfung wichtig, wenn Schatten, überlappende Ränder oder niedrig auflösende Bilder zu Unklarheiten führen.
Eine zweite Aufgabe betrifft unregelmäßige Mare-Gebiete, kleine vulkanische Strukturen, die jünger erscheinen als ein Großteil des umliegenden Geländes. Ihre Kartierung hilft Forschern, Erklärungen zur vulkanischen und thermischen Entwicklung des Mondes zu überprüfen. Das Modell kann diese Strukturen schneller segmentieren als eine manuelle Suche, sodass Wissenschaftler mehr Zeit für die Interpretation ihrer Verteilung und die Entscheidung haben, welche Gebiete genauer beobachtet werden sollten.
Die dritte Anwendung, die Suche nach potenziellen Polareisvorkommen, hat die größte operative Relevanz. Dauerhaft beschattete Krater können so kalt bleiben, dass Eis über Milliarden von Jahren erhalten bleibt. Die NASA-Übersicht zum Mondwasser erklärt, dass Eisvorkommen Aufschluss darüber geben könnten, wie Wasser auf den Mond gelangte und sich dort ausbreitete. In einem zukünftigen Erkundungsprogramm könnte zugängliches Wasser auch die Trinkwasserversorgung, die Sauerstoffproduktion oder die Treibstoffgewinnung unterstützen. Allerdings identifizieren potenzielle Vorkommenskarten eher wahrscheinliche Standorte, als die Menge, Reinheit oder Gewinnbarkeit eines Vorkommens zu überprüfen.
Offener Zugang erweitert den Test
NASA und IBM haben die Modellsammlung auf Hugging Face, einschließlich separater Downstream-Versionen für die Kratererkennung, die Eisprospektion und die Segmentierung unregelmäßiger Mare-Patches. Durch die Veröffentlichung erhalten Universitäten und kleinere Forschungsgruppen Zugang zu einem System, dessen eigenständiges Training sehr kostspielig wäre. Zudem schafft es eine gemeinsame Basis für den Vergleich neuer Ansätze, anstatt jedes Labor zu zwingen, einen anderen Ausgangspunkt zu entwickeln.
Das zugehörige Code-Repository bietet Werkzeuge für Feinabstimmung und Inferenz, die Integration mit dem Open-Source-Framework TerraTorch sowie Konfigurationen für nachgelagerte Aufgaben. Die NASA hat außerdem für maschinelles Lernen geeignete Datensätze und Benchmark-Sammlungen veröffentlicht. Im Repository wird darauf hingewiesen, dass kein Code für das Vortraining enthalten ist. Diese Einschränkung müssen Forschende bei der Bewertung der Reproduzierbarkeit des ursprünglichen Trainingsprozesses berücksichtigen.
Offene Gewichte und Quellcodes beseitigen nicht automatisch andere Hürden. Der Betrieb eines großen Bildverarbeitungsmodells erfordert weiterhin Rechenressourcen, technisches Fachwissen und sorgfältige Datenverarbeitung. Forschende müssen zudem prüfen, ob Benchmark-Datensätze geografische oder sensorbedingte Verzerrungen aufweisen, ob Trainingsbilder mit dem Evaluierungsmaterial übereinstimmen und wie sich Modellfehler in Regionen mit extremer oder uneinheitlicher Beleuchtung verändern.
Warum Mondbilder schwierig sind
Der Mond stellt die Computer-Vision vor besondere Herausforderungen. Da er fast keine Atmosphäre besitzt, wird sein Erscheinungsbild stark vom Einfallswinkel des Sonnenlichts geprägt, und in Polnähe kann ein und dasselbe Merkmal bei verschiedenen Beobachtungen völlig anders aussehen. Tiefe Schatten können Kraterböden verdecken, während helle Hänge die sichtbare Textur reduzieren. Die NASA weist darauf hin, dass sich ändernde Lichtverhältnisse auf die Sichtbarkeit kleinerer Krater auswirken können, selbst wenn das darunterliegende Gelände unverändert bleibt.
Die Auflösung stellt eine weitere Einschränkung dar. Das Trainingsarchiv kombiniert Bildmaterial mit einer Pixelgröße von etwa 1 bis 100 Metern. Das bedeutet, dass eine Datenebene ein Gebilde im Bereich einzelner Felsblöcke zeigen kann, während eine andere lediglich dessen geologische Umgebung erfasst. Ein Modell muss sinnvolle Zusammenhänge zwischen diesen verschiedenen Maßstäben erkennen, ohne jede Abweichung als physikalische Veränderung zu interpretieren. Seine Vorhersagen sollten daher am besten als Hilfsmittel zur Priorisierung von Expertenanalysen betrachtet werden, nicht als Ersatz für die Kalibrierung von Instrumenten oder geologische Fachkenntnisse.
Der zugehörige technische Bericht und die Benchmarks ermöglichen es Spezialisten, die Architektur, die Trainingsmethoden und die aufgabenspezifische Leistung zu überprüfen. Die wichtigsten weiteren Erkenntnisse werden aus unabhängigen Auswertungen von Daten gewonnen, die nicht von den Entwicklern des Modells ausgewählt wurden, darunter Beobachtungen anderer Missionen und neu aufgenommene Bilder. Eine Verbesserung von 23 % bei einem Benchmark kann bedeutsam sein, ohne dass dies auf alle Mondregionen oder wissenschaftlichen Ziele gleichermaßen zutrifft.
KI wird zur wissenschaftlichen Infrastruktur
Das Mondmodell ist Teil einer umfassenderen Initiative von NASA und IBM zur Entwicklung wiederverwendbarer KI-Systeme für die Wissenschaft. Frühere Prithvi-Modelle befassten sich mit Erdbeobachtung, Wetter, Überschwemmungen, Ernten und Hurrikanen, während ein Sonnenmodell für die Weltraumwettervorhersage entwickelt wurde. Die KI-Strategie sieht in diesen Systemen einen Weg, um aus großen, öffentlich zugänglichen Datensätzen, die schneller wachsen, als Forschende sie manuell auswerten können, einen größeren Nutzen zu ziehen.
Dieser Ansatz kann die Wirtschaftlichkeit wissenschaftlicher Software verändern. Durch das Training eines breit anwendbaren Modells und dessen offene Bereitstellung können sich viele Teams die hohen Anfangskosten teilen und ihre Ressourcen anschließend in Validierung und spezialisierte Anwendungen investieren. Zudem verbessert sich die Vergleichbarkeit von Studien, wenn Forschende ihre Ergebnisse anhand derselben Benchmarks berichten. Der Nachteil besteht darin, dass ein weit verbreitetes Basismodell seine Schwächen in vielen Projekten offenbaren kann, weshalb Dokumentation und unabhängige Tests unerlässlich sind.
Der unmittelbare Kontext dieser Mission ist das Artemis-Programm, das Erfahrungen für die langfristige Erforschung des Mondes und spätere Marsmissionen sammeln soll. Verbesserte Karten könnten helfen, potenzielle Landegebiete einzugrenzen, Gefahren im Gelände zu identifizieren und Standorte für direkte Ressourcenmessungen zu priorisieren. Das Modell wählt jedoch nicht selbstständig einen Landeplatz aus; technische Beschränkungen, Kommunikationsmöglichkeiten, Beleuchtung, wissenschaftliche Ziele und direkte Beobachtungen fließen weiterhin in die Entscheidung ein.
Was die Veröffentlichung festlegt
Die NASA-IBM-Veröffentlichung zeigt, dass ein einzelnes vortrainiertes System bei verschiedenen Mondkartierungsaufgaben konkurrenzfähig ist und dass die Entwickler wichtige Ressourcen zur Überprüfung freigeben. Sie beweist jedoch nicht, dass jede Vorhersage korrekt ist, dass vermutetes Eis abgebaut werden kann oder dass automatisierte Analysen Planetenforscher ersetzen können. Diese Unterscheidungen sind besonders wichtig, wenn ein KI-Ergebnis kostspielige Missionen oder sicherheitskritische Planungen beeinflusst.
In der nächsten Phase wird sich zeigen, ob das Modell sich als dauerhafte Forschungsplattform etabliert oder lediglich eine erfolgreiche Demonstration darstellt. Die Nutzung durch unabhängige Teams, die Leistungsfähigkeit bei neuen Missionsdaten, die transparente Berichterstattung über Fehler und messbare Reduzierungen der Analysezeit werden den praktischen Nutzen besser belegen. NASA und IBM haben die technischen Hürden für den Einsatz fortschrittlicher Computer Vision auf dem Mond gesenkt und das System der wissenschaftlichen Gemeinschaft zugänglich gemacht, die nun herausfinden muss, wie weitreichend seine Vorteile sind.











